前面的“消息系统”已经说明:模型可以返回一个包含 toolCall 的 AssistantMessage;工具完成后,运行时会写入 ToolResultMessage。“事件驱动”则说明外部代码如何观察这段过程。
本文的实现依据是本机 pi-minimal-agent 锁定的 @earendil-works/pi-agent-core@0.85.1。版本升级后请重新核对 API 名称,但不要丢掉这条职责边界。
先看一个看似简单的请求
假设你对 Agent 说:
帮我看看 config.json 里有没有 apiBaseUrl。如果 Agent 有一个 read_file 工具,模型可能返回这样的结构化内容:
{
  "type": "toolCall",
  "id": "call_42",
  "name": "read_file",
  "arguments": { "path": "config.json" }
}
此时文件还没有被读取。模型输出的只是数据:工具叫什么、这次调用的唯一 ID 是什么、参数是什么。它没有直接运行 Node.js,也没有直接打开 config.json。
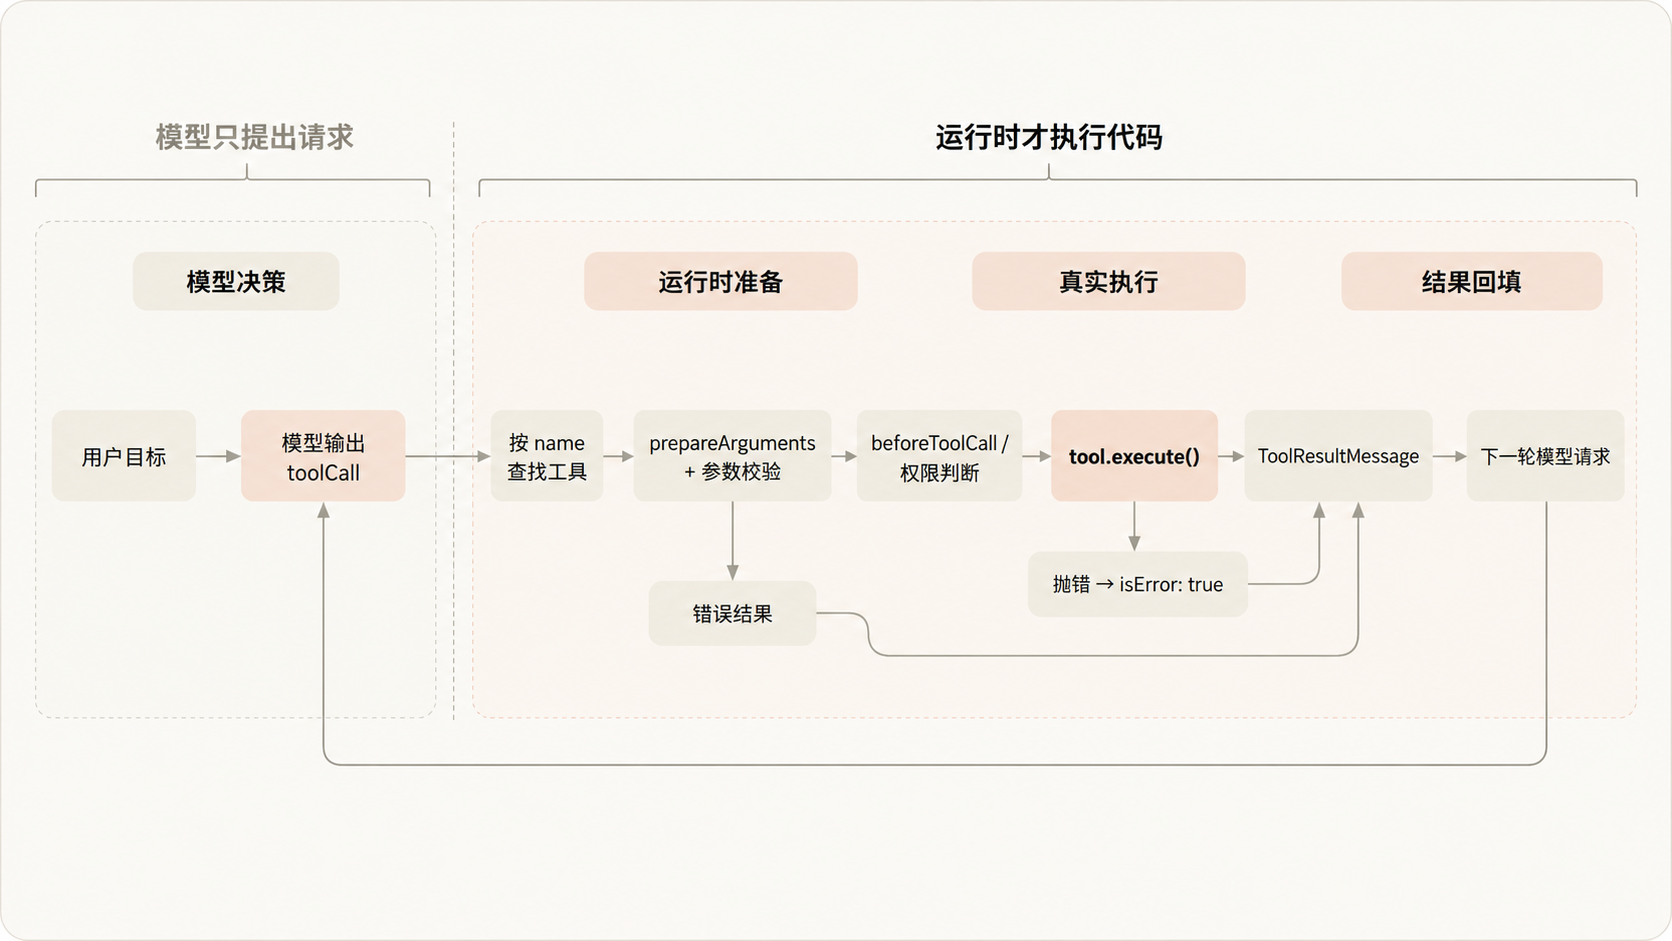
模型输出 toolCall ≠ 工具已经执行。模型负责决定“我想要一个什么动作”;运行时负责判断“这个动作能不能执行,以及执行它的代码是什么”。
工具本身不是一句提示词,而是一份可执行定义
Agent 要执行工具,内存里至少要有一份工具定义。可以把它压缩成三个部分:
| 部分 | 回答的问题 | 典型内容 |
|---|---|---|
name | 模型请求的名字对应谁? | read_file |
parameters | 参数怎样才算合法? | path 必须是字符串 |
execute() | 合法请求最终调用哪段代码? | fs.readFile(path) |
Pi 的 AgentTool 还可以包含 label、prepareArguments、executionMode 等字段。它们分别服务于界面显示、参数兼容、串行或并行执行。核心是把可被模型调用的名字、可验证的输入和真实副作用代码绑在一起。
const readFileTool = {
  name: "read_file",
  label: "Read File",
  description: "读取一个文本文件",
  parameters: Type.Object({
    path: Type.String(),
  }),
  execute: async (toolCallId, params, signal, onUpdate) => {
    const text = await fs.readFile(params.path, "utf-8");
    onUpdate?.({
      content: [{ type: "text", text: "读取完成" }],
      details: { path: params.path },
    });
    return {
      content: [{ type: "text", text }],
      details: { path: params.path },
    };
  },
};
模型不会跳进这个 execute 函数。Agent 创建时,应用把 readFileTool 放入 context.tools;之后 Agent Loop 才能根据 toolCall.name 找到它。
第一步:按名称找到工具
模型返回 name: "read_file" 后,Agent Loop 会在当前可用工具集合中查找同名项:
toolCall.name
    → currentContext.tools.find(tool => tool.name === toolCall.name)
    → 找到 AgentTool
找不到时,运行时不会“猜一个相似工具”,也不会执行模型写在参数里的代码。它会构造一个错误工具结果,例如“Tool read_file not found”,然后继续把这个结果交给模型。
所以,模型可见的工具列表和运行时真正启用的工具列表必须一致。只把工具写进系统提示词,却没有放进 context.tools,模型可以提出请求,但运行时仍然找不到可执行对象。
第二步:先准备,再校验参数
找到工具之后,Pi Core 不会立刻调用 execute(),而是先处理参数。
prepareArguments 不是执行工具
工具可以提供 prepareArguments 做确定性的兼容转换,但它不应该偷偷读取文件、调用网络或产生业务副作用:
模型原始 arguments
    → prepareArguments(可选的纯参数整理)
    → validateToolArguments
    → 已验证的 params
之后 Schema 校验把不可信输入挡在执行门外。如果模型返回 {path: 123},校验会失败,execute() 根本不会被调用;错误会被包装成工具结果,交给下一轮模型修正。
工具调用不是“模型 JSON → 直接执行”,而是“模型 JSON → 找工具 → 整理参数 → 校验参数 → 才可能执行”。
第三步:执行前还可以拦截
参数通过校验后,Pi Core 还提供 beforeToolCall。它适合做权限、目录范围、人工确认、取消状态和危险操作检查。
找到工具
  → 参数准备
  → Schema 校验
  → beforeToolCall
  → tool.execute()
如果 beforeToolCall 返回阻止结果,运行时会跳过 execute(),生成一个 isError: true 的工具结果。提示词可以告诉模型“不要读密钥”,但真正的权限边界仍应由代码检查。
第四步:execute() 才是现实世界的动作
经过前面的门槛后,Agent Loop 才会调用:
await tool.execute(toolCall.id, validatedArgs, signal, onUpdate);execute() 内部可以做什么 | 结果 |
|---|---|
| 读文件、查数据库 | 得到真实数据 |
| 发 HTTP 请求 | 产生外部服务调用 |
| 修改游戏状态或业务状态 | 发生真实副作用 |
调用 onUpdate | 向 UI 发送执行中的进度 |
| 抛出异常 | 被运行时转换成工具错误 |
工具函数应该在失败时抛错,而不是把错误伪装成成功文本。Pi 会捕获抛出的异常,把它变成带 isError: true 的工具结果。signal 提供取消边界;onUpdate 是过程通知,不是最终结果。
第五步:结果为什么能回到正确的调用
工具完成后,运行时会把 AgentToolResult 转成标准的 ToolResultMessage:
{
  "role": "toolResult",
  "toolCallId": "call_42",
  "toolName": "read_file",
  "content": [{ "type": "text", "text": "...文件内容..." }],
  "isError": false
}
toolCallId 就是连接请求与结果的钥匙:
AssistantMessage { toolCall: { id: "call_42" } }
                         │
                         └── tool.execute()
                                │
ToolResultMessage { toolCallId: "call_42" }
结果被追加回当前 Agent 上下文后,Agent Loop 才会继续下一轮模型请求。模型看到的是一条明确关联到 call_42 的工具结果,于是可以继续判断下一步。
工具执行结束后,为什么还会再调用模型
工具通常只完成一个动作,不知道用户最终想怎样组织答案。运行时把结果加入消息历史后,会再次请求模型:
UserMessage
  → AssistantMessage(toolCall)
  → tool.execute()
  → ToolResultMessage
→ 下一轮 AssistantMessage- 模型根据当前上下文提出工具请求。
- 运行时执行请求,或返回拒绝/错误结果。
- 结果进入消息上下文。
- 模型根据新结果决定下一步。
tool_execution_start、tool_execution_update、tool_execution_end 是观察过程的运行时事件;ToolResultMessage 才是会进入下一轮模型上下文的事实记录。
多个工具调用:串行和并行不是一回事
一次 AssistantMessage 可能包含多个 toolCall。Pi Core 支持两种执行模式:
| 模式 | 怎么执行 | 适合什么 |
|---|---|---|
sequential | 一个完成后再执行下一个 | 有顺序依赖、会修改同一资源 |
parallel | 先逐个准备和校验,再并发执行允许并行的工具 | 多个互不依赖的读取任务 |
并行时,工具完成事件按实际完成顺序发出,但写入上下文的工具结果仍按助手消息中的调用顺序排列。如果某个工具声明必须串行,整个批次会退回串行处理;executionMode 是运行时调度约束,不是 UI 标签。
错误发生在哪里,结果就在哪里回填
工具系统常见的错误不是一种:
| 阶段 | 例子 | 是否调用 execute() |
|---|---|---|
| 找工具 | name 不存在 | 否 |
| 参数准备/校验 | path 不是字符串 | 否 |
| 执行前拦截 | 权限不足、用户拒绝 | 否 |
| 真实执行 | 文件不存在、HTTP 超时 | 是,但执行失败 |
前三类是“动作尚未发生就被拒绝”,最后一类是“动作已经开始,但执行过程中失败”。不能只看模型最后说了什么来判断真实世界是否发生过副作用。
工具系统不是“给模型一个函数,模型自己运行它”,而是一个受运行时控制的请求协议:
模型输出 toolCall
  → 按 name 查找工具
  → prepareArguments
  → 参数校验
  → beforeToolCall / 权限判断
  → tool.execute()
  → 成功结果或 isError: true
  → ToolResultMessage
  → 下一轮模型请求
判断一个工具系统是否设计清楚,可以只问:谁把名字映射到函数?参数在哪里校验?谁掌握权限、取消和副作用?结果怎样通过 toolCallId 回到下一轮上下文?
文中核验来源:Pi Agent Core README、Agent Loop 实现、类型定义,以及上一篇消息系统和事件驱动。