战斗代码怎样让另外两个模块知道这件事?最直接的做法,是战斗代码在确认击败后,依次调用更新任务和记录击杀的函数。事件驱动提供了另一种组织方式:战斗代码报告“敌人已击败”,提前登记过的处理函数随后得到调用。
这里值得看清的,是“报告之后”到底发生了哪些普通程序操作。下面用同一个例子拆开它。
先把发生的事情写成数据
假设战斗模块负责扣除生命值,也负责判断敌人是否刚刚进入死亡状态。它确认 7 号敌人已经被击败,才创建这样一份记录:
const event = {
  type: "enemyDefeated",
  enemyId: 7,
  kind: "slime"
};
type 说明发生了哪种事,enemyId 指出是哪只敌人,kind 让收到记录的人知道它属于哪种敌人。这份对象就是本例的事件数据。“事件”在业务上指已经发生的事情,在程序里则需要用具体的数据表示,才能传给其他代码。
记录本身没有行为。创建这个对象,不会让任务数字自动增加,也不会执行某个神秘的后台程序。要改变进度,必须有人真正执行修改进度的代码。
这里还藏着一个业务责任:战斗模块应当在敌人刚被击败时报告一次。如果敌人尸体留在场景里,后面每一帧都报告一次“生命值为零”,订阅者就可能把同一次击败算很多次。事件机制负责传递,何时算一件新事实由业务代码决定。
订阅,就是先保存“这类事件交给哪个函数”
先写出接收事件后要做的两件事。为看清数字的变化,暂时只用内存变量代表任务和统计数据:
let questProgress = 2;
let killCount = 4;

function updateQuest(event) {
  if (event.kind === "slime") {
    questProgress += 1;
  }
}

function recordKill(event) {
  killCount += 1;
}
任务只统计史莱姆,所以 updateQuest 先读 kind;击杀统计对所有敌人都加一,所以 recordKill 不需要这个判断。这两条响应规则由各自的处理函数拥有。
接下来需要一个地方,记住哪些函数关心哪一类事件。下面是专为讲解写的小型实现,不是某个框架的源码:
const subscriptions = new Map();

function on(type, handler) {
  if (!subscriptions.has(type)) {
    subscriptions.set(type, []);
  }
  subscriptions.get(type).push(handler);
}

on("enemyDefeated", updateQuest);
on("enemyDefeated", recordKill);
运行两次 on 后,表中 enemyDefeated 对应的数组里有两个函数引用,依次是 updateQuest 和 recordKill。函数引用可以理解为程序以后能够调用这个函数的入口。
特别留意 on("enemyDefeated", updateQuest) 的最后一个参数:这里把函数交给 on 保存,没有写 updateQuest(...) 来执行它。此时任务仍然是 2/3,统计仍然是 4。订阅的效果是建立关系,响应要等到分发代码真正调用函数。
这种关系通常在模块初始化或启用时建立,并在模块退出时移除。否则已经关闭的界面、已经结束的关卡也可能继续收到通知。本例先省略移除接口,只保留能看清调用的部分。
发布之后,分发代码怎样找到处理者
再加上十行以内的分发函数:
function emit(event) {
  const handlers = subscriptions.get(event.type) ?? [];
  for (const handler of handlers) {
    handler(event);
  }
}

emit({ type: "enemyDefeated", enemyId: 7, kind: "slime" });
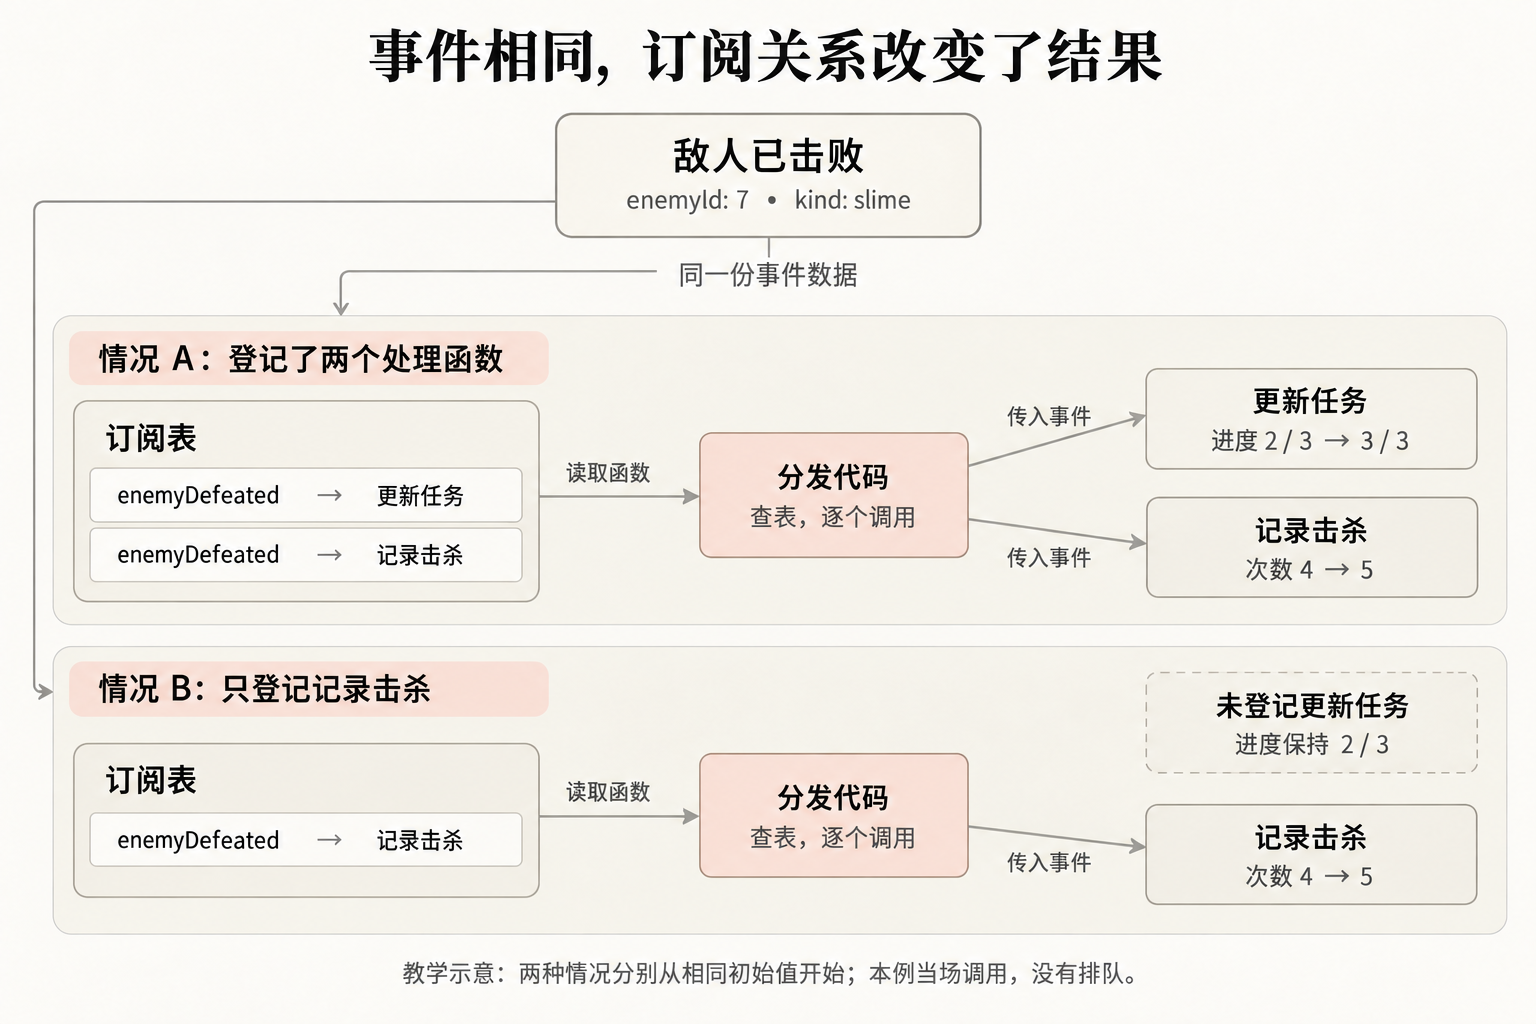
emit 的名字常被译为“发出事件”。在这个实现里,它做的事情很具体:先用 event.type 查表,得到两个函数;再依次执行 handler(event),把同一份事件对象当参数传进去。
第一次循环调用 updateQuest。函数看到 kind 是 slime,把 questProgress 从 2 改成 3,然后返回 emit。第二次循环调用 recordKill,把 killCount 从 4 改成 5,再返回。循环结束,emit 才返回它的调用位置。
因此,这条链上的职责可以准确落到代码上:战斗模块确认事实并产生记录,on 保存订阅关系,emit 查表并调用,处理函数改变各自拥有的状态。所谓“事件触发任务更新”,展开以后就是这些步骤。执行代码的仍然是程序的线程。
下面的图固定事件内容和初始数字,只改变订阅表。看图时注意右下方没有连线的任务进度:分发代码没有拿到它的函数,就没有调用它。
 打开原尺寸图示查看细节 ↗
改变条件,变化发生在哪一步
把两个处理函数都登记好,仍从任务 2/3、击杀 4 开始。如果战斗报告的是 kind: "bat",emit 依然会调用两个函数:订阅表按事件类型查找,并不检查敌人种类。随后 updateQuest 自己判断这不是史莱姆,保持进度为 2;recordKill 仍然加到 5。
再把事件改回史莱姆,但初始化时只登记 recordKill。这一次 updateQuest 根本没有被调用,所以任务也保持为 2;统计仍变成 5。两种情况的最终数字相同,原因却不同:前者收到通知后决定不更新,后者从来没有收到通知。
如果一个函数都没登记,查表得到空数组,循环一次也不会执行。这份事件也不会被本例保存起来。后来再订阅,并不能补收到之前那次击败。
| 每次都从任务 2/3、击杀 4 开始 | 实际调用的函数 | 处理后结果 |
|---|---|---|
| 两个订阅,击败史莱姆 | 更新任务、记录击杀 | 任务 3/3,击杀 5 |
| 两个订阅,击败蝙蝠 | 更新任务、记录击杀 | 任务 2/3,击杀 5 |
| 只订阅统计,击败史莱姆 | 记录击杀 | 任务 2/3,击杀 5 |
| 没有订阅,击败史莱姆 | 无 | 任务 2/3,击杀 4 |
这些是本文教学实现的实际运行结果,完整示例与输出保存在随文文件中。它们也说明,排查事件问题不能只问“有没有发出”:还要看当时登记了谁,以及收到数据后采用了什么规则。
与直接调用相比,究竟改变了什么
同一个需求完全可以这样写:
function afterEnemyDefeated(event) {
  updateQuest(event);
  recordKill(event);
}
它和前面的同步分发最终都会调用这两个函数。区别在于,直接写法把接收者名单放在 afterEnemyDefeated 的代码里;事件写法把名单放在初始化时建立的订阅关系里。
假如现在要加一个“击败后播放提示”的模块,直接写法需要在这里补上 playNotice(event)。事件写法则可以由新模块登记 on("enemyDefeated", playNotice),战斗模块继续报告同一种事实。哪个模块启用、哪个模块退出,都可以通过登记关系改变响应集合。
这就是事件驱动在本例中带来的空间:发生事情的模块负责把事实说清楚,各个功能模块决定如何响应。新增一个独立响应时,不必把它的具体函数塞进战斗逻辑。
这种安排也有成本。阅读战斗代码,只能看见它发出了 enemyDefeated,看不见所有后续行为;要继续追踪,就得找到订阅发生的位置。事件名称和字段还成了共同约定:如果战斗模块把 kind 改了名字,而任务模块仍读旧字段,双方照样会出问题。连接方式变灵活了,约定仍然必须维护。
如果战斗结算必须拿到某个函数的返回值才能继续,或者两步操作必须严格按业务顺序完成,明确的直接调用通常更容易表达这个要求。不要把必须完成的步骤随意藏进一组可有可无的监听者里。本文的任务通知是为解释协作机制选择的例子;真实游戏若要求击杀与任务进度作为一个不可分割的结算,就需要另外设计这个一致性边界。
事件可以当场处理,也可以稍后处理
前面的代码里没有 await、定时器和线程创建。emit 进入循环,处理函数返回后才继续执行;因此,发布方会花时间等待这些同步调用完成。若一个处理函数做很慢的计算,发布方就会在这里停留很久。若第一个处理函数抛出异常,而外面没有捕获,循环会中断,后面的处理函数也不会自动获得执行机会。
真实库也能采用这种方式。Node.js 的 EventEmitter.on 登记监听函数,emit 按登记顺序同步调用它们;监听函数的返回值不会变成 emit 的业务结果。其 error 事件还有特殊规则,不能把本文普通事件“没有订阅就略过”的行为直接套过去。Node.js Events 文档
想稍后再处理,就要增加保存和取出的步骤
假设战斗结算期间只想先收集通知,等本轮结算结束后统一分发,可以明确加一个队列:
const pendingEvents = [];

function publishLater(event) {
  pendingEvents.push(event);
}

function flushEvents() {
  const batch = pendingEvents.splice(0);
  for (const event of batch) {
    emit(event);
  }
}
现在执行 publishLater(event) 只把对象放入数组。此刻任务仍是 2/3,统计仍是 4。应用在结算结束的位置调用 flushEvents() 后,才会取出这批记录,逐条交给前面的 emit,最后得到任务 3/3、统计 5。
“稍后”由谁实现,在这里可以直接指出来:应用代码决定何时调用 flushEvents。只创建队列而没人调用它,事件就一直留在数组里。这段示例也没有建立后台线程,更没有把数组保存到磁盘;进程退出后,未处理的数据就不能靠它恢复。
队列还引入了一项原先不明显的选择:查哪一刻的订阅表?这份代码在 flushEvents 调用 emit 时才查表,所以入队后、分发前新增的订阅者,也会收到尚未分发的事件。若业务要求固定“事件产生当时的接收者”,实现就必须另存名单。排队改变了时间,随之而来的规则要由代码明确。
事件循环负责安排运行机会
在浏览器和 Node.js 中,还经常听到“事件循环”。它属于宿主运行环境的调度机制,帮助安排待执行的工作获得运行机会。JavaScript 的当前同步工作没有让出执行权时,别的排队回调不会仅因“已准备好”就插进来执行;具体队列和阶段规则取决于宿主。MDN:执行模型;Node.js:事件循环
本例的 subscriptions 保存的是“谁关心哪种事件”,pendingEvents 保存的是“哪些业务记录还没分发”。宿主的事件循环处理的是运行调度。它们回答不同的问题,因此不能看见 emit 这个名字,就推断宿主一定替它排了一次队。
同样,把监听函数写成 async 也不意味着分发器会等待它全部完成。一个异步函数执行到 await 后可以暂停,之后再恢复;调用方若只是普通地执行 handler(event),并没有因此获得“所有响应都已完成”的保证。MDN:await
判断一套事件系统的执行时机,最终要找出三段代码:在哪里保存通知,在哪里取出通知,以及在哪里调用处理函数。它们有时集中在一个同步函数里,有时分布在应用调度和运行时回调中。
处理者搬到另一台机器后,边界在哪里
继续沿着同一个游戏设想:击杀统计现在交给独立的数据服务处理。任务进度仍留在游戏进程内,统计服务可能运行在另一台机器。
原来保存在数组中的 recordKill 是本进程里的函数引用。把这个引用放进事件对象,并不能让另一台机器执行那个函数。要越过边界,游戏端需要把约定好的字段编码成可传输的数据,通过通信通道发送;服务端接收、解析,再由它自己的代码调用统计处理函数。
一种部署方式是在中间加入消息代理:游戏服务向某个主题发布记录,代理根据订阅安排投递,统计服务的接收代码再处理它。代理是需要部署和运行的基础设施,与前面内存里的 Map 不在同一个尺度。微软的架构文档从生产者、传输通道和消费者三个职责描述这种跨组件架构。Azure Architecture Center:事件驱动架构
跨进程后,一次调用的返回也更难代表整个业务完成。发布成功可能只说明发送或接收的某一步已经完成,要以通信接口的具体承诺为准;统计服务可能还没修改数据,也可能已处理成功却没能及时回传确认。
于是需要考虑重复、失败和延迟。例如同一次击败被重新投递时,简单执行 killCount += 1 就会多算。可以给每次事实一个稳定的 eventId,让统计服务把“是否处理过这个编号”与统计修改一并可靠记录,避免重复计数。这里的 enemyId: 7 只标识敌人,并不自动构成跨对局唯一的事件编号。这是本例对可靠性问题的设计说明,尚未实现消息基础设施。
任务 3/3 而远程统计暂时仍为 4,也可能成为正常的短暂状态。能否接受这个间隔、怎样重试、是否需要持久保存、如何追踪失败,都应按业务要求和所选基础设施设计。跨服务事件架构能让消费者独立演进,也带来投递和一致性方面的工作;这些保证不会由“事件驱动”四个字自动提供。Azure 架构文档的挑战说明
把它放回软件体系里
现在可以给“事件驱动”一个有具体内容的定位:它组织的是组件之间的协作——一个组件报告发生的事情,其他组件按照登记关系或接收规则作出响应。
在开发时,事件接口可能来自自己写的业务代码、一个库,也可能是框架提供的扩展方式。代码加载进入进程之后,订阅关系成为内存数据,分发和处理成为真正的函数执行。需要跨服务时,协作又延伸到进程间通信,并依赖网络、操作系统和消息设施。选用事件协作,并不会把库、运行时和操作系统重新变成一套事件专属的上下级。
下面的局部示意保留了这几个不同视角。先看上方进程包含的代码与状态,再看下方独立服务需要经过的通信边界;图里的“调度”单独回答何时执行。
 打开原尺寸图示查看细节 ↗查看统一软件知识地图的事件区域
回到那只倒下的史莱姆,任务数字的变化已经能落到一个明确的位置:emit 查到 updateQuest,执行 handler(event),任务函数读到 kind: "slime",于是修改自己拥有的进度。把这几个动作接起来,事件驱动就成了一种可以顺着代码追踪的安排。