先抓住一个具体区别:一次操作尚未完成时,调用它的那段程序,是必须留在这次调用里,还是已经拿回控制权,可以把后续工作安排到以后? 从这里出发,再看线程,就不会把“异步”直接理解成“另外开一个线程”。
从“拿到资料再显示”开始
假设有一个同步读取接口,调用者这样使用它:
// 教学伪接口,不是浏览器提供的真实 API
const profile = readProfileSync();
showProfile(profile);
console.log("调用之后");
这里约定 readProfileSync() 成功返回时就给出完整资料。如果服务器还没有把资料送来,这次调用就不能成功返回,调用者也无法执行下一行。出错则从调用处抛出错误。操作的完成被包含在这一次调用之内,这是本例的同步接口约定。
注意,“同步”不表示耗时长。Math.max(3, 8) 也是同步调用,只是通常很快就把结果算出来了。让网页卡住的是把昂贵计算或漫长等待放进主线程当前这段执行里。
现在把接口换成浏览器真实提供的 fetch():
const pendingResponse = fetch("/api/profile");
console.log("请求已经发起,可以继续执行");
这次返回的是一个 Promise。它表示这次请求未来会得到的结果或失败,不是已经拿到的个人资料。调用者可以先继续运行,之后再通过 Promise 的完成状态安排处理。这里,函数调用返回与网络操作完成被分开了,这就是异步接口带来的变化。MDN:使用 Fetch API
同步与异步描述的是这里选定的操作和调用约定。“同步数据”中的“同步”还可能表示让两份数据保持一致,那是另一种语境;本文一直讨论程序的执行与等待。
写上 await,停下的是这一次函数执行
资料没到就无法显示用户名,所以我们仍然需要表达先后依赖。下面是一段浏览器代码,假设页面中已有 #status 和 #name 两个元素,服务端接口会返回包含 name 的 JSON:
async function loadProfile() {
  const status = document.querySelector("#status");
  status.textContent = "正在加载";

  try {
    const response = await fetch("/api/profile");
    if (!response.ok) {
      throw new Error(`HTTP ${response.status}`);
    }

    const profile = await response.json();
    document.querySelector("#name").textContent = profile.name;
    status.textContent = "加载完成";
  } catch (error) {
    status.textContent = `加载失败:${error.message}`;
  }
}

loadProfile();
console.log("调用 loadProfile 之后");
调用 loadProfile() 时,它会先开始执行,找到状态元素并写入“正在加载”。运行到第一个 await,先求值右侧表达式,也就是调用 fetch(),然后才等待它返回的 Promise。
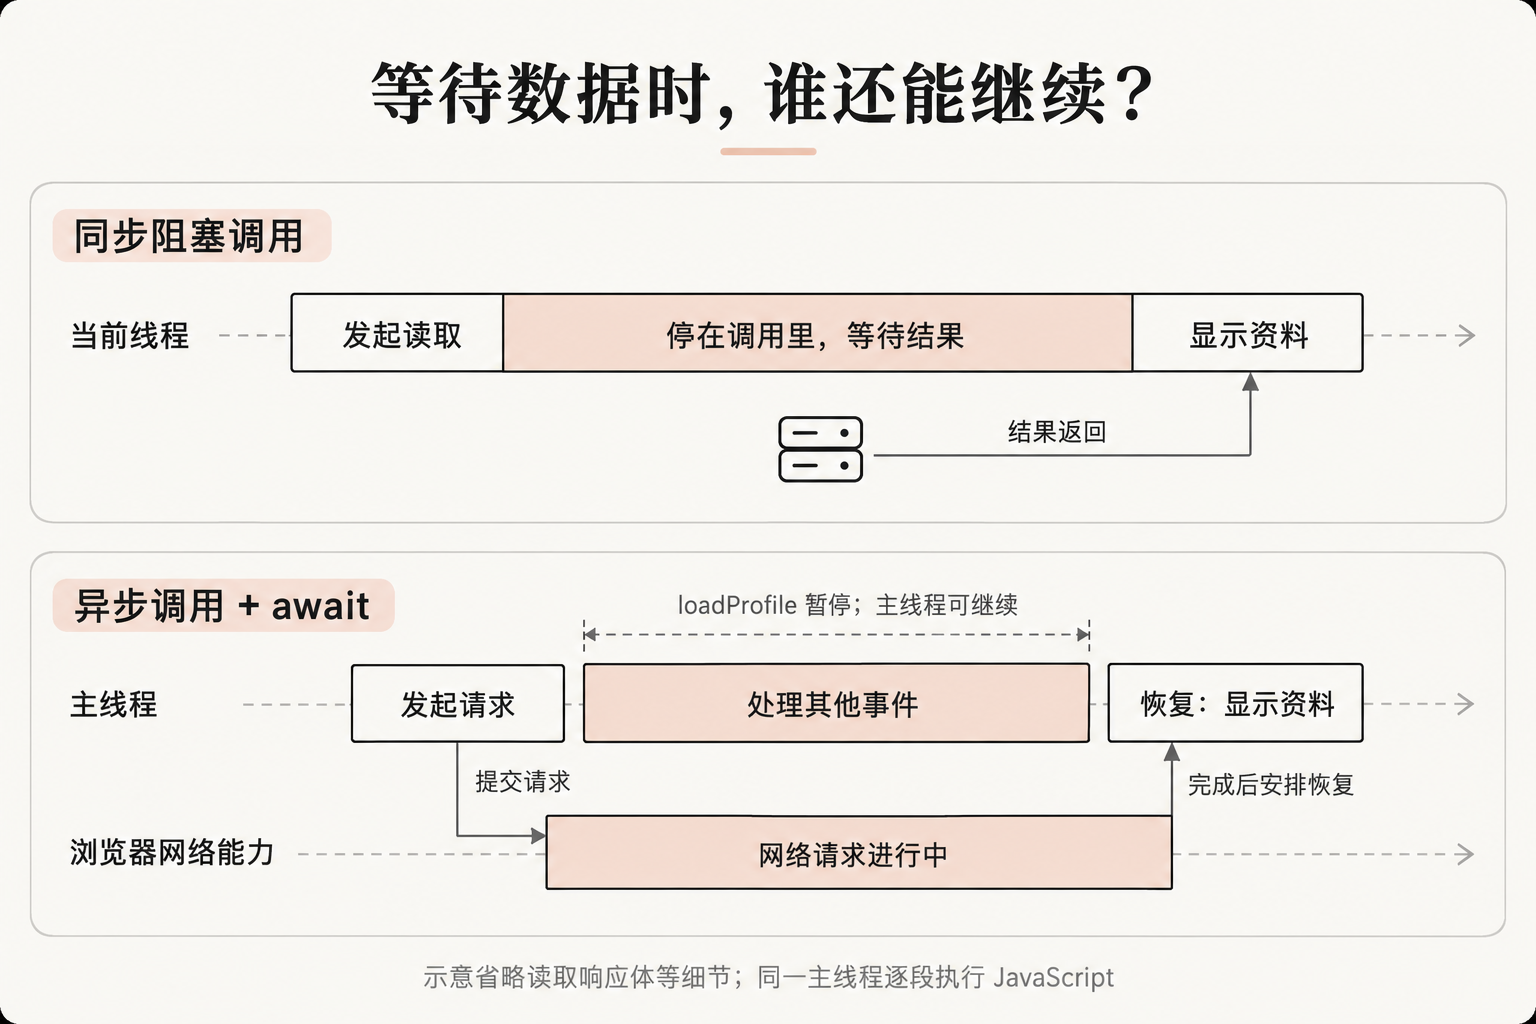
此时,这一次 `loadProfile` 的执行被挂起,调用者拿回控制权,所以外面的日志可以先输出。函数内的 if、读取 JSON、显示用户名都要等到相应恢复点才能执行。async 函数返回的也是 Promise,调用者可以用它观察这次函数执行何时结束。async 不会把开头这段代码搬到后台。MDN:async function
下面的图把“函数还在等”和“线程还能干活”分开画。上半部分采用前面假定的同步阻塞接口,下半部分对应 loadProfile 的异步等待。
 打开原尺寸图示查看细节 ↗
这里有两个不同层面的“继续”:函数外面的日志可以接着本次调用执行;按钮事件、绘制等其他工作,则要等当前执行交还给浏览器、到达合适的调度机会。并不是写到 await 的瞬间,浏览器就必然刷新了一帧。
如果调用者也写了 await loadProfile(),那么调用者自己的这一次异步函数执行也会等待。等待沿着业务依赖向上传递,但不会因此把主线程整体冻结。对于本文这种函数内的 await,挂起的范围是包含它的这一次异步函数执行;模块顶层 await 还有模块求值依赖的规则,不能机械套成“整个程序暂停”。MDN:await
函数暂停以后,请求是谁在处理
可以把这次加载拆成三个一直存在的角色:应用代码规定拿到资料以后做什么;浏览器提供网络与调度能力;操作系统、网络设备和远端服务参与真正的数据传输与处理。
fetch() 把请求交给浏览器的宿主能力。请求进行时,不需要让主线程不断执行一段 JavaScript 循环来“等网络”。浏览器如何把网络工作分配给内部线程或进程,是具体实现问题;单看 await fetch(...) 无法数出底层开了几个线程。Promise 负责表达结果状态,不能把它当成一个会自己跑网络的工作线程。
当某个等待的 Promise 已经完成,等待它的代码也不会直接抢占正在运行的 JavaScript。恢复执行需要被调度;await 后面的续段通过微任务机制继续。这里“续段”就是先前暂停之后仍需执行的代码与所需状态,不要求程序员手工拆出一个新函数。即使等待的值已经可用,await 后的部分也不会在原来的同步执行段里直接接上。MDN:await 的控制流效果
在同一个 JavaScript agent 内,一段正在运行的工作会执行到交还控制权;其他工作不会任意插进它的每一条语句之间。浏览器主线程上的这些 JavaScript 片段可以交替执行,但不会因此在同一时刻执行两段。事件循环、任务和微任务共同参与安排,而“异步”这个词本身没有承诺具体的队列结构。MDN:JavaScript 执行模型
代码里的两个 await 还各有目的。第一个等待 Response,此时通常已经有响应状态和响应头,却不代表响应体全部读完;第二个等待 response.json() 完成响应体读取并得到解析结果。HTTP 404 这类状态也不会自动使 fetch 的 Promise 拒绝,所以示例显式检查了 response.ok。MDN:处理响应
同步与阻塞,需要分别指出观察对象
前面的同步读取同时也是阻塞等待,很容易让人把两个词当作同义词。它们关心的对象不同。
| 观察问题 | 对应概念 | 在本例中怎么判断 |
|---|---|---|
| 操作完成是否包含在本次调用里,还是通过之后的完成机制处理? | 同步 / 异步 | fetch() 返回 Promise 后,请求还可以在进行 |
| 数据没准备好时,这一次底层调用会不会让调用线程等待? | 阻塞 / 非阻塞 | 阻塞读取可以等到有数据;非阻塞读取可先报告暂时没有数据 |
| 多项工作在一段时间内是否交错推进? | 并发 | 请求尚未结束,页面仍可处理另一件事 |
| 多项工作是否真的在同一时刻执行? | 并行 | 需要具体执行资源和调度情况支持,不能只看 async |
例如 Linux 的 socket 接收:阻塞模式下,没有消息时,recv() 可以等待;非阻塞模式下,它可以立即返回 EAGAIN 或 EWOULDBLOCK,告诉调用者现在还读不到。这次调用尽快返回,不等于原本想要的资料已经拿到。 后续是否重试、怎样等到可读、是否把这些动作封装成异步 API,还要看上层安排。Linux man-pages:recv(2)
所以不要只给整个程序贴“同步”或“非阻塞”的标签。一个对外异步的库,可以在内部工作线程中执行阻塞读取;外部调用者先拿回控制权,内部那个工作线程却仍在等待,两种说法可以同时成立。反过来,如果代码在主线程里不断重试非阻塞读取,单次系统调用没有等待,外层循环仍可能占住主线程。
这也解释了为什么“阻塞”要说明作用范围。操作系统把等待中的线程暂时停下来,并不表示整台机器不工作;同一机器上的其他线程仍可能得到执行机会。而网页主线程长时间不能回到事件循环,就足以让这个页面的交互失去响应。
异步给出了重叠的机会,不保证并行,也不保证更快
继续沿用资料页面。假设它还要显示一份与用户名无关的通知数量,两个网络请求可以独立发起。下面的 getJson 将前面的状态检查和 JSON 读取收进同一个帮助函数:
async function getJson(url) {
  const response = await fetch(url);
  if (!response.ok) throw new Error(`HTTP ${response.status}`);
  return response.json();
}

// 先后等待:第一个完成后才发起第二个
const profile = await getJson("/api/profile");
const notices = await getJson("/api/notices");
这段代码假设位于另一个 async 函数内。两次请求都是异步操作,但业务写法让它们依次进行。如果改为下面这样,两次调用都会先发起,再一起等待:
const [profile, notices] = await Promise.all([
  getJson("/api/profile"),
  getJson("/api/notices"),
]);有意义的变化发生在调用时机:第二个请求不再等第一个完成。Promise.all 聚合这些 Promise 的结果;请求由 getJson() 中实际执行的 fetch() 发起。假设两项分别耗时约 300 毫秒、200 毫秒,且资源充足、彼此独立,顺序等待约需 500 毫秒,重叠进行则可能接近较长的 300 毫秒。这是忽略开销的教学估算,不是实测性能承诺。MDN:Promise.all
这里展示的是都成功时的路径。任意一项拒绝,Promise.all 返回的 Promise 就会拒绝,需要由外层处理失败;这不会自动取消另一个已经发起的请求。
如果通知地址必须用资料返回的用户标识才能构造,前面的依赖依然存在,不能为了“并发”提前发出一个还不知道参数的请求。异步让等待不必占住原来的执行流程,业务依赖仍由业务本身决定。
同样,这两个请求重叠进行,并不证明网页里两段 JavaScript 正在两个 CPU 核上同时计算。需要把大量计算移出浏览器主线程时,可以明确使用 Web Worker;Worker 有自己的执行环境,通常通过消息与页面交换数据,也不能像主线程一样直接操作 DOM。异步消息是沟通方式,独立执行资源是另一项安排。MDN:使用 Web Workers
为什么加了 async,页面还是会卡
把一段耗时计算包进 async,并不会自动改变它的执行位置:
async function prepareReport() {
  const report = calculateLargeReport(); // 假设是耗时同步计算
  return report;
}

await prepareReport();
为了得到 await 右侧的值,必须先调用 prepareReport();它又会先执行那段计算。主线程仍然要把计算跑完。即使把计算放到某个 await 之后,它恢复时也还是在原来的 JavaScript 执行环境中运行。
实际需要判断耗时来自哪里:网络等待可以由异步 I/O 留出调度机会;大段 CPU 计算可能需要拆分任务、改变算法或明确交给 Worker。Node.js 也区分事件循环与工作线程池:网络 I/O 等待不等于每次请求占用一个线程,而部分文件、加密等任务会用工作线程池。把耗时计算放进主事件循环里的回调,照样会拖慢其他请求。Node.js:不要阻塞事件循环或工作线程池
放回软件体系:接口、调度和系统能力各负其责
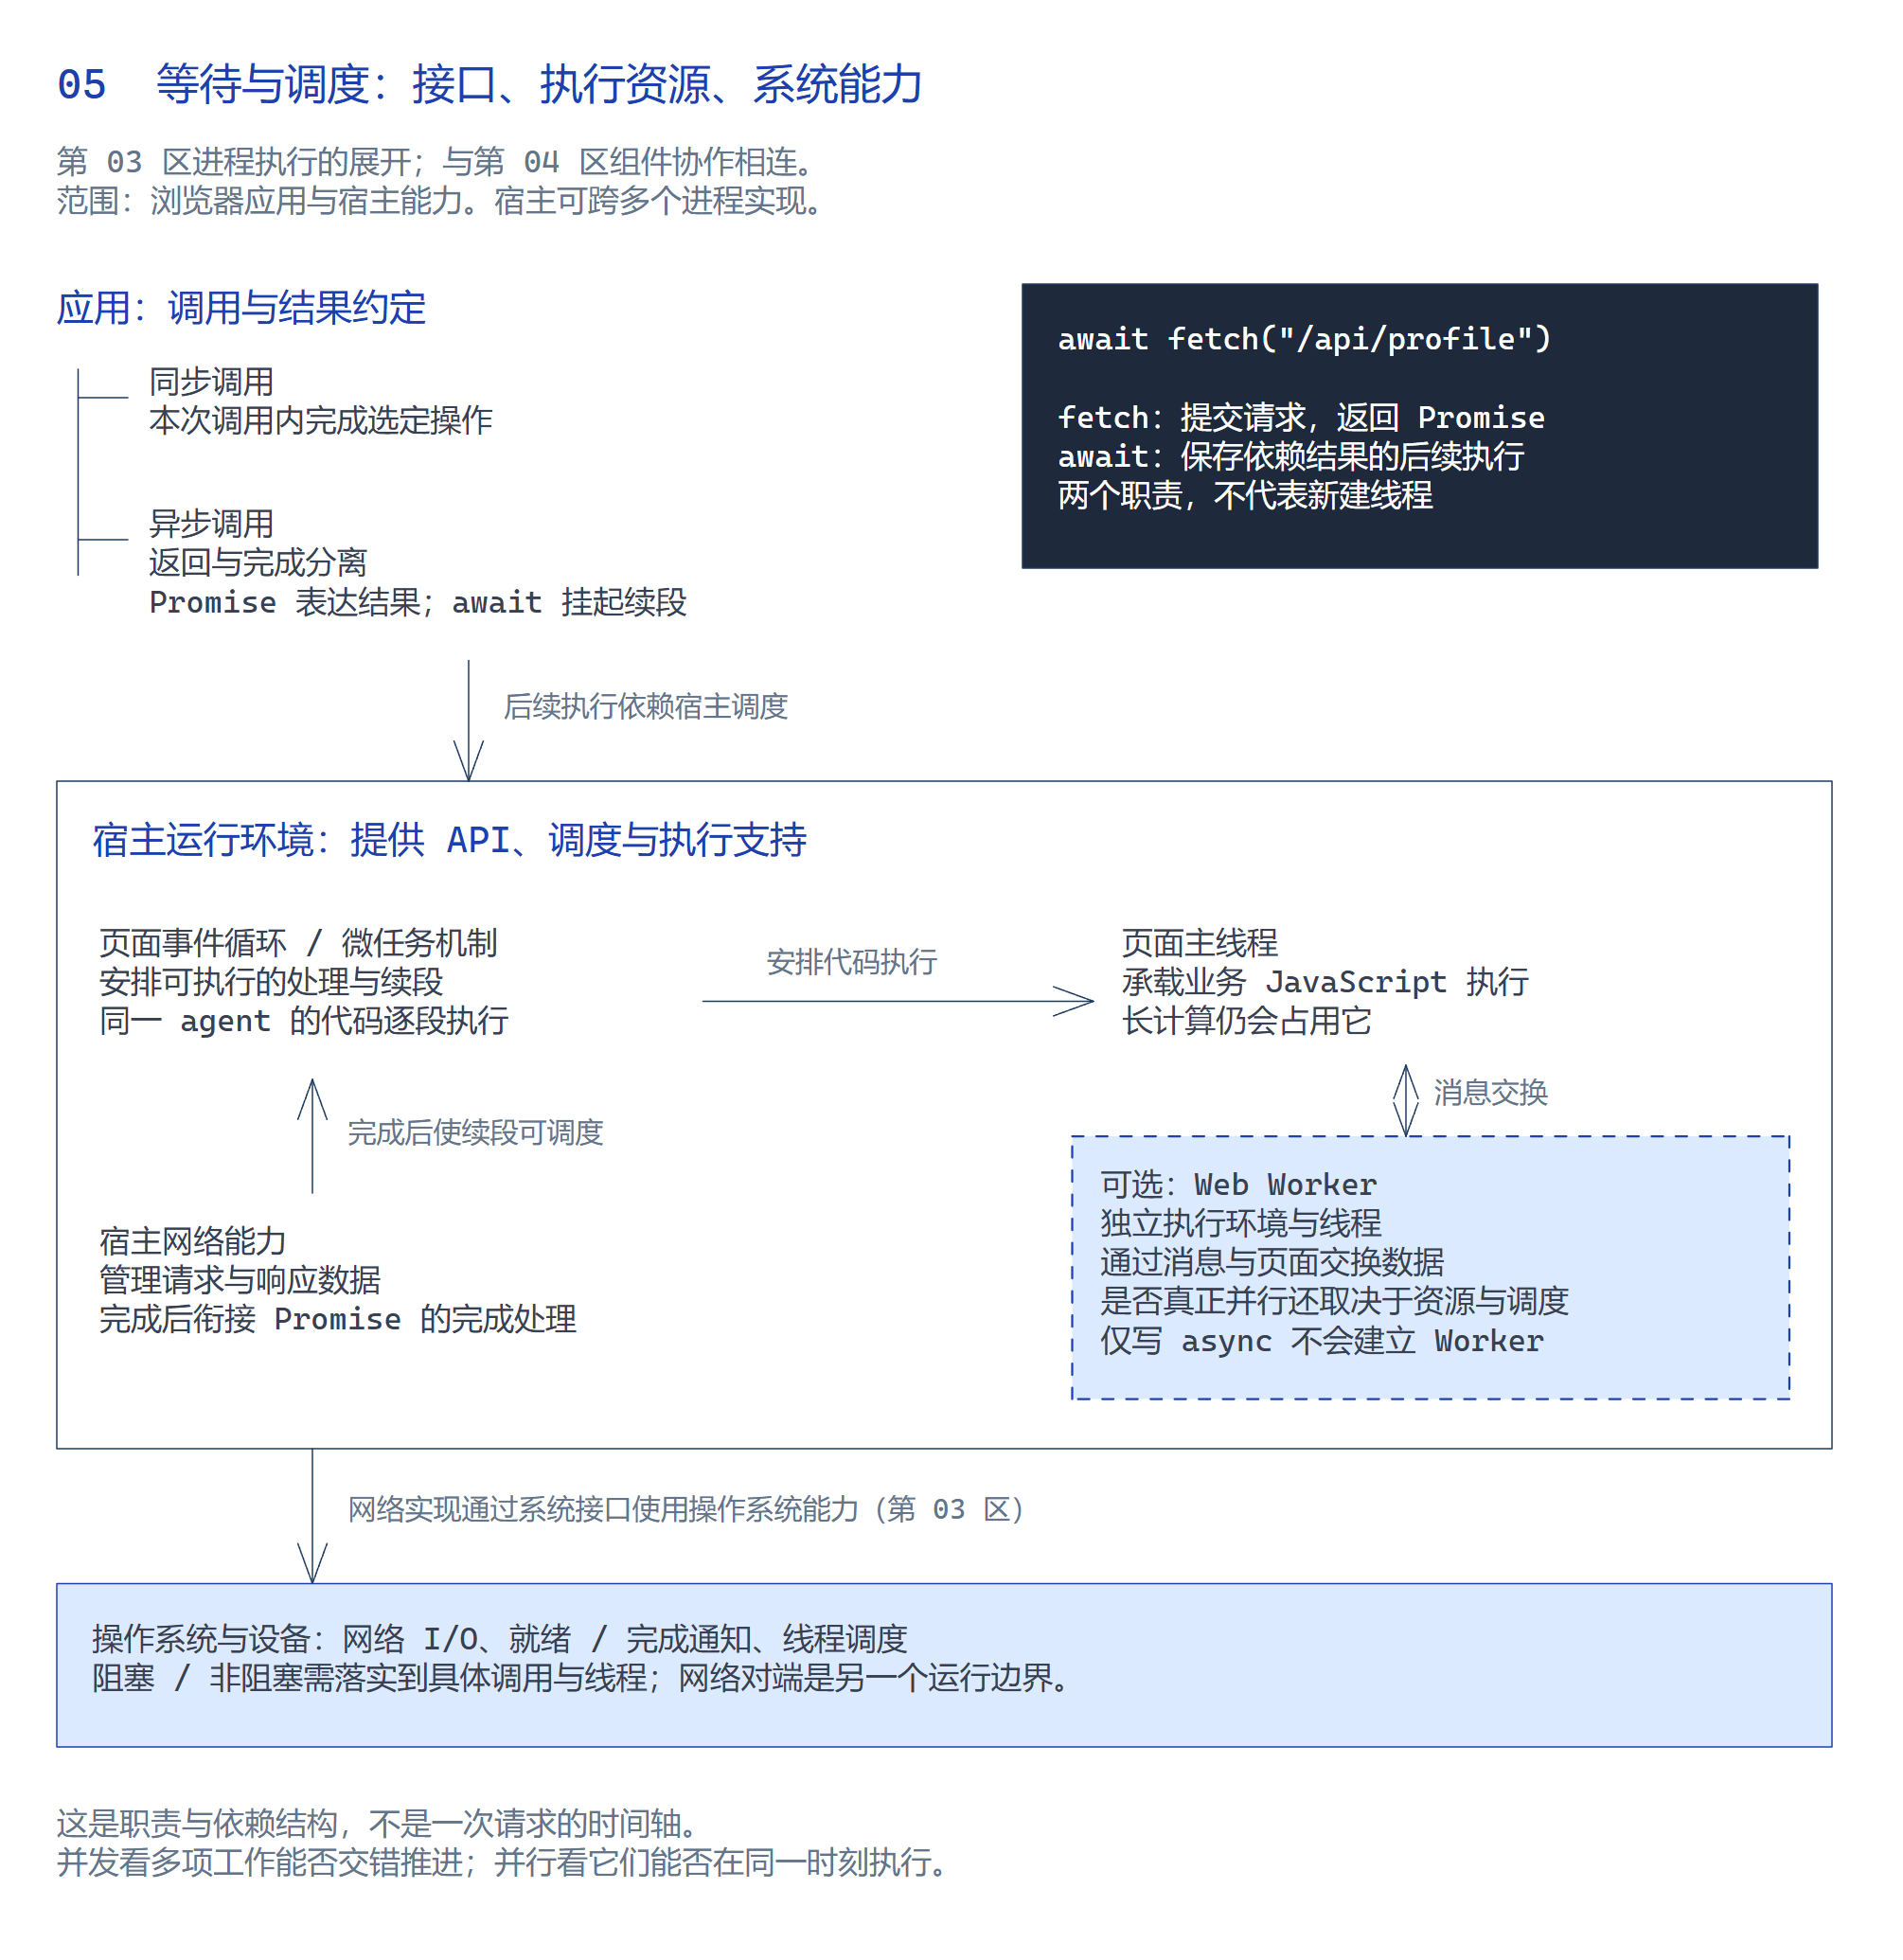
到这里,可以给这次请求中的名词找到稳定的位置。业务代码决定“拿到资料以后显示什么”,API 规定如何发起和取得结果,Promise 保存完成状态并关联后续处理,宿主的调度机制安排代码什么时候继续,线程承载实际执行,底层网络能力依赖操作系统与设备。
下面是软件体系白板的第 05 区,连接前面的“进程执行”和“组件协作”。它展示长期存在的职责与边界;前面的等待图则展示一次请求如何经过这些部件。
 打开原尺寸图示查看细节 ↗下载完整可编辑软件体系地图
这份结构也能接住“事件驱动”:它说明发生什么后交给谁响应;同步或异步再说明响应是在当前调用中完成,还是稍后继续。事件回调可以当场执行,也可以经调度执行,是否使用事件并不能单独决定是否异步。
回到最开始的按钮,await 让“等资料再显示”保持容易阅读的先后顺序,同时允许本次函数执行暂时让出控制权。之后判断一段代码时,沿这条链辨认:调用何时返回,结果何时可用,等待时哪段执行暂停,最终又由谁安排它继续。这样就能把页面表面的“还在加载”落实到实际的接口、状态、调度和执行位置。